Equipo de tres — Ingeniería de Big Data, Miami Dade College2026
Comprobar si los géneros cinematográficos necesitan modelos separados
La segmentación por género está justificada estadísticamente: un único modelo global para todos los géneros no supera una prueba de significación formal.
- películas
- 330.970
- años cubiertos
- 106
- segundos de pipeline
- 31
- PySpark
- Databricks
- Spark Structured Streaming
- Python
Problema
Los estudios y las plataformas de streaming modelan habitualmente el rendimiento de las películas con un único modelo global para todo el catálogo. La pregunta era si eso resulta defendible, o si los géneros difieren lo suficiente como para requerir un modelado por separado.
Datos
Los conjuntos de datos públicos de IMDb — 330 970 películas que abarcan 106 años, unidas a partir de títulos, valoraciones y metadatos. Procesados con PySpark en Databricks. El proyecto incluía además un componente de Spark Structured Streaming, con el pipeline completo ejecutándose en unos 31 segundos.
Método
Uniones y agregaciones distribuidas en PySpark, después contraste formal de hipótesis sobre si las diferencias entre géneros en la distribución de las notas son estadísticamente significativas, y por último un modelo de regresión de la nota.
Resultados
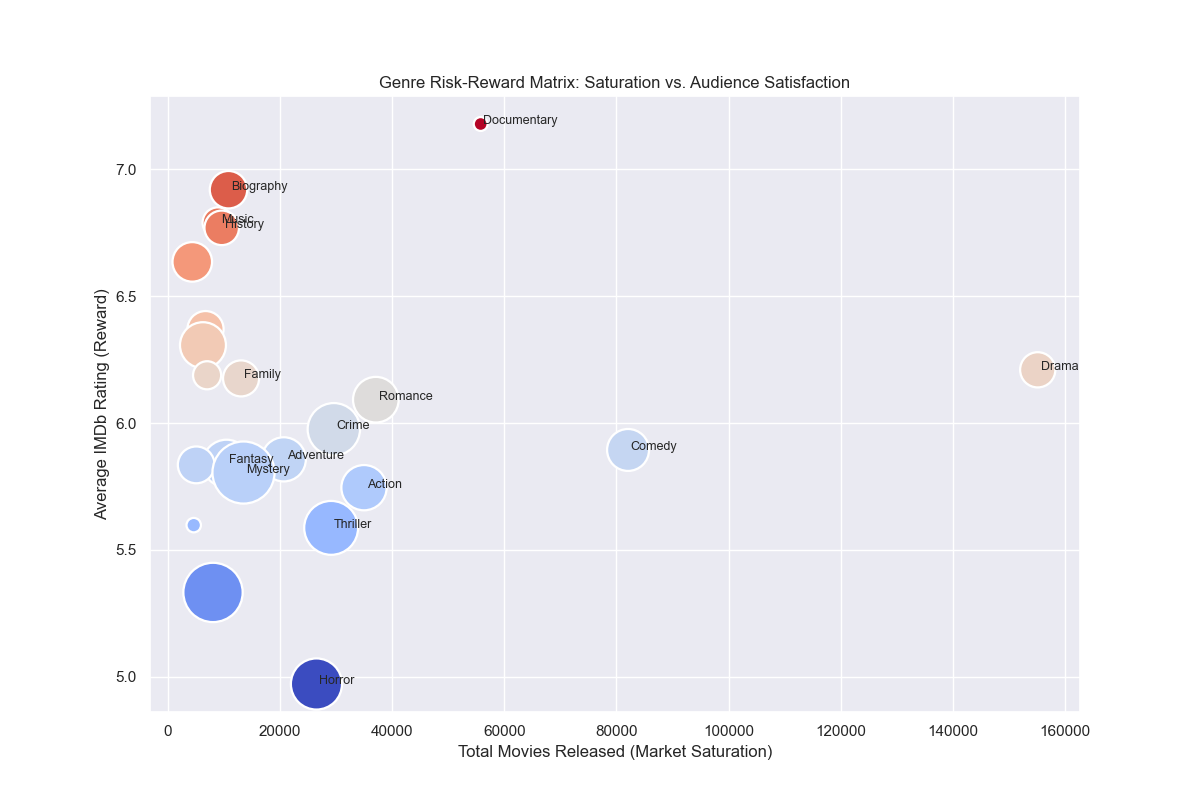
Las diferencias entre géneros son significativas: los datos no justifican un único modelo global. La matriz riesgo-rendimiento separa los géneros según su nota media frente a la varianza de sus notas, y muestra que algunos géneros se mantienen sistemáticamente en valores intermedios mientras que otros son apuestas de alta varianza.
El modelo de regresión resultó débil. El RMSE se situó en torno a ±1,5 puntos de nota en una escala de 10 donde las notas promedian cerca de 6,2, y el R² fue bajo. Las valoraciones de las películas dependen en gran medida de factores ausentes en los metadatos —reparto, inversión en marketing, momento del estreno, recepción crítica— y el modelo lo refleja.
Limitaciones. Parte de los datos de 2026 de este pipeline es sintética, y en el repositorio se documenta un problema de calidad conocido. Cualquier conclusión sobre los años recientes debe considerarse provisional.
Implicaciones
El resultado defendible es el contraste de hipótesis, no el modelo: segmentar por género antes de modelar está justificado, y agrupar los géneros no lo está. La regresión se lee mejor como evidencia de cuánto de la recepción de una película queda fuera de sus metadatos.