Équipe de trois — Ingénierie des données massives, Miami Dade College2026
Vérifier si les genres cinématographiques exigent des modèles distincts
La segmentation par genre est statistiquement justifiée : un modèle global unique appliqué à tous les genres échoue à un test de significativité formel.
- films
- 330 970
- années couvertes
- 106
- secondes de pipeline
- 31
- PySpark
- Databricks
- Spark Structured Streaming
- Python
Problème
Les studios et les plateformes de diffusion modélisent couramment la performance des films à l'aide d'un modèle global unique appliqué à l'ensemble du catalogue. La question était de savoir si cette approche est défendable, ou si les genres diffèrent suffisamment pour exiger une modélisation distincte.
Données
Les jeux de données publics d'IMDb — 330 970 films couvrant 106 ans, joints à partir des titres, des notes et des métadonnées. Traitement réalisé avec PySpark sur Databricks. Le projet comportait également un volet Spark Structured Streaming, le pipeline complet s'exécutant en une trentaine de secondes.
Méthode
Jointures et agrégations distribuées avec PySpark, puis tests d'hypothèses formels visant à déterminer si les différences de distribution des notes entre genres sont statistiquement significatives, puis un modèle de régression de la note.
Résultats
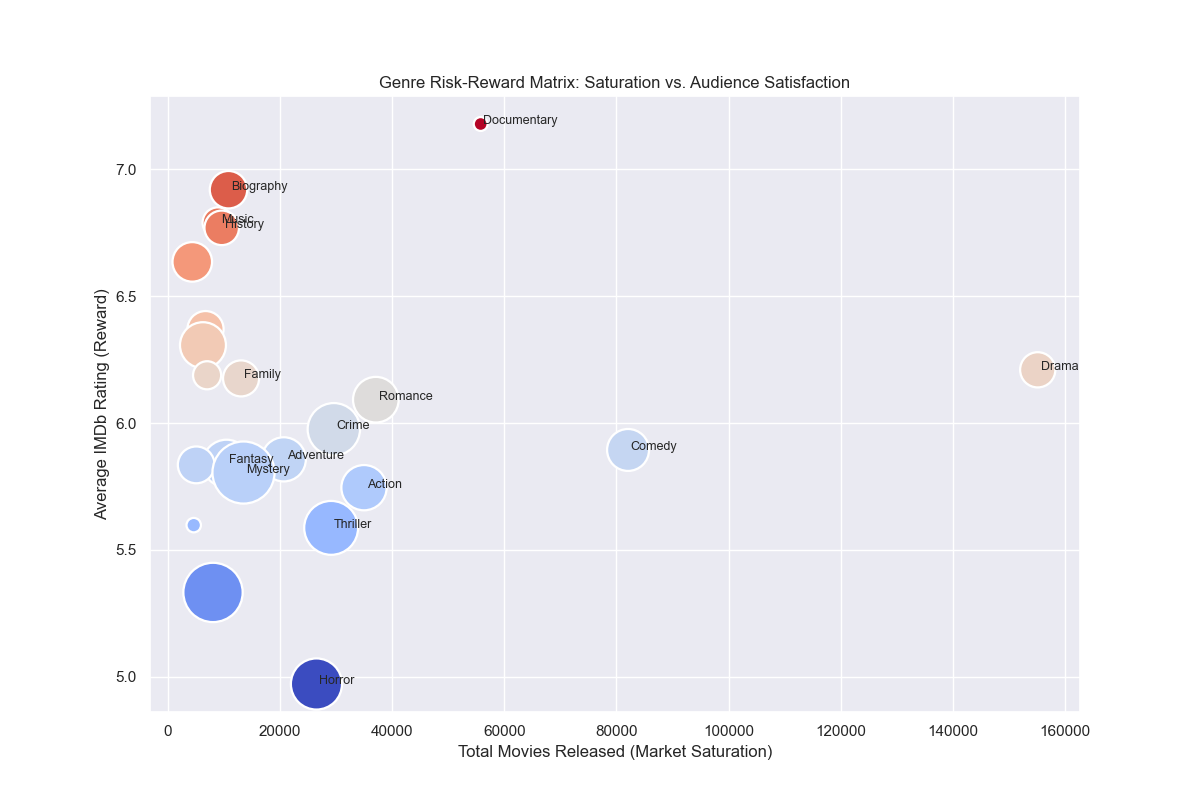
Les différences entre genres sont significatives — un modèle global unique n'est pas justifié par les données. La matrice risque-rendement sépare les genres selon leur note moyenne et la variance de leurs notes, montrant que certains genres restent systématiquement moyens tandis que d'autres constituent des paris à forte variance.
Le modèle de régression s'est révélé faible. La RMSE s'établit autour de ±1,5 point de note sur une échelle de 10 où les notes avoisinent 6,2 en moyenne, et le R² était faible. Les notes des films dépendent fortement de facteurs absents des métadonnées — distribution, budget marketing, calendrier de sortie, réception critique — et le modèle en porte la trace.
Limites. Une partie des données de 2026 de ce pipeline est synthétique, et un problème de qualité connu est documenté dans le dépôt. Toute conclusion portant sur les années récentes doit être considérée comme provisoire.
Portée
Le résultat défendable est le test d'hypothèse, non le modèle : segmenter par genre avant de modéliser est justifié, regrouper les genres ne l'est pas. La régression se lit surtout comme une mesure de la part de la réception d'un film qui échappe à ses métadonnées.